Étude de cas · 2026
Archipelle
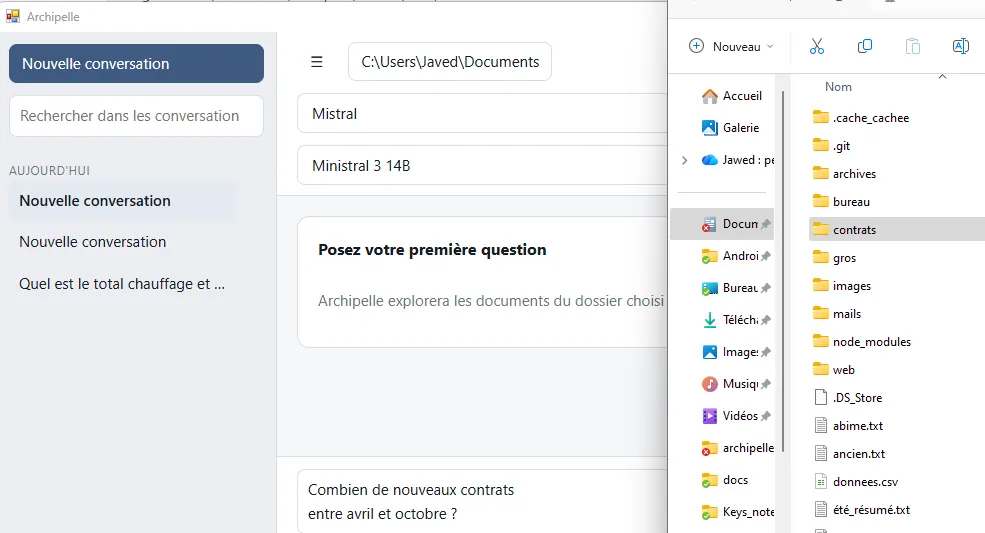
Une application de bureau à qui l'on pose une question sur un dossier de son ordinateur. Elle cherche la réponse au moment où on la demande, lit les documents pertinents et cite les fichiers dont elle s'est réellement servie.
- 0index ou copie de vos fichiers
- Lecture seuleaucun outil d'écriture dans le programme
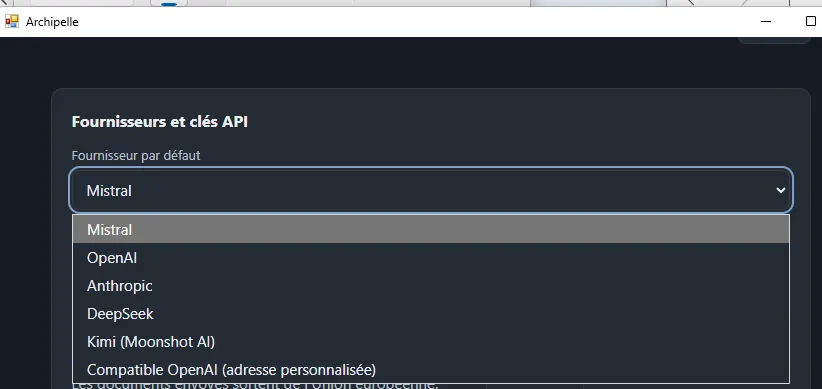
- 6+fournisseurs d'IA, dont des modèles locaux
- ~40formats lus (PDF, Office, e-mails, code…)
Le problème
Retrouver une information dans ses propres fichiers est un problème banal, et curieusement mal résolu. La recherche du système d'exploitation trouve des noms de fichiers, pas des réponses. Les outils d'IA qui « discutent avec vos documents » imposent presque tous la même étape préalable : copier vos documents dans une base spécialisée.
Ce mécanisme, le RAG vectoriel classique, a trois conséquences concrètes :
- il faut attendre la fin de l'indexation avant de poser la première question ;
- il faut la relancer à chaque modification, sous peine de travailler sur une image périmée du dossier ;
- il existe désormais, quelque part sur le disque, une seconde copie du contenu de vos documents.
Les contraintes
- Confidentialité : les fichiers ne quittent pas la machine. Seuls les extraits nécessaires à la réponse partent chez le fournisseur d'IA choisi, et un avertissement signale les fournisseurs situés hors de l'Union européenne.
- Fraîcheur : la réponse doit porter sur le dossier tel qu'il est au moment de la question.
- Fiabilité des sources : un nom de fichier inventé ressemble beaucoup à un nom de fichier réel. Les citations doivent être exactes, pas seulement plausibles.
- Indépendance vis-à-vis du modèle : l'outil doit fonctionner avec plusieurs fournisseurs, et même avec un serveur local, sans qu'aucune donnée ne sorte de la machine.
L'architecture
Archipelle n'a pas de base vectorielle. Un agent reçoit la question et dispose d'outils en lecture seule : parcourir l'arborescence, chercher dans le contenu, ouvrir un fichier, lancer la reconnaissance de texte sur un document scanné. Il enchaîne ces appels jusqu'à pouvoir répondre, ou jusqu'à atteindre un plafond d'étapes.
Pendant ce temps, le programme tient un journal des fichiers réellement lus. C'est ce journal, et non le modèle, qui sert à vérifier les sources.
flowchart TB
    Q["Question en français
sur un dossier choisi"] --> A{"Agent LLM
Mistral, OpenAI, Anthropic,
DeepSeek, Kimi, Ollama…"}
    subgraph OUTILS["Outils en lecture seule"]
        T1["Parcourir l'arborescence"]
        T2["Chercher dans le contenu"]
        T3["Lire un fichier"]
        T4["OCR Tesseract
mode Exploration"]
    end
    A -->|appels d'outils| OUTILS
    OUTILS -->|extraits| A
    OUTILS -.->|chaque lecture| J[("Journal des
fichiers lus")]
    A -->|réponse + citations| V{"Vérification
par le programme"}
    J --> V
    V -->|fichier présent dans le journal| OK["Source vérifiée
fichier cliquable"]
    V -->|fichier absent| KO["Source signalée
« non vérifiée »"]
    A -.->|plafond atteint, fichier protégé,
scan non traité| L["Limites annoncées
dans la réponse"]
Une zone de transparence affiche en direct les recherches en cours, les fichiers consultés et ceux qui ont été écartés, avec la raison. Un bouton d'arrêt interrompt la recherche immédiatement.
Les choix écartés
| Option | Pourquoi elle a été écartée |
|---|---|
| RAG avec base vectorielle | Indexation préalable, copie des documents, résultats périmés dès que le dossier change. |
| Laisser le modèle citer ses sources | Un modèle produit des références plausibles, pas des références exactes. C'est l'une des formes d'hallucination les plus difficiles à repérer. |
| Donner des droits d'écriture à l'agent | Aucun bénéfice pour la question posée, et un risque réel sur les fichiers de l'utilisateur. Le programme ne contient tout simplement aucun outil d'écriture. |
| OCR systématique | Coûteux en temps sur chaque question. L'OCR est réservé au mode Exploration, et son absence est annoncée plutôt que masquée. |
Deux modes de recherche
Le mode Rapide va au plus direct et répond en peu d'étapes. Le mode Exploration enchaîne davantage d'étapes et active la reconnaissance de texte sur les documents scannés : il est plus lent, et se réserve aux questions qui le méritent.
Sécurité et données
- Les fichiers restent sur la machine : seuls les extraits utiles à la réponse sont transmis au fournisseur choisi. Avec un serveur local (Ollama, LM Studio), rien ne sort.
- Lecture seule par construction : le programme ne peut ni modifier, ni supprimer, ni créer de fichier.
- Historique local : conversations, cache d'extraction et journaux restent sur la machine et s'effacent depuis les paramètres.
- Clés API protégées : rangées dans un fichier aux droits restreints, jamais réaffichées en clair, jamais journalisées.
Résultats et limites
Archipelle est publié sur PyPI (pip install archipelle) sous licence MIT. Le projet est outillé comme un logiciel destiné à durer : environnement géré avec uv, tests Python (pytest) et tests de l'interface web, lint avec ruff, typage vérifié avec pyright.
Un outil honnête annonce ce qu'il ne fait pas bien. Le projet en assume quatre :
- Les très petits modèles s'en sortent mal. En dessous de huit milliards de paramètres, un modèle enchaîne difficilement les appels d'outils successifs d'une exploration.
- La recherche est plafonnée. Sur un très gros dossier, l'exploration s'arrête avant d'avoir tout vu, et la réponse indique que la couverture est partielle. C'est un choix de conception : le plafond existe pour que la recherche se termine.
- L'OCR dépend d'un programme externe. Sans Tesseract, les documents scannés sont signalés comme non lus, sans erreur ni blocage.
- La qualité de la rédaction dépend du modèle. Archipelle organise la recherche et vérifie les sources ; le style de la réponse reste celui du modèle choisi.
Rôle et stack
Développement mené par Jawed Tahir, qui publie le code et suit les retours sur le dépôt GitHub. Projet réalisé en partenariat avec Virgule-Studio, qui a apporté des ressources techniques et l'architecture globale.
Stack : Python 3.12, agents LLM avec appels d'outils, interface web embarquée, Tesseract (OCR), uv, pytest, ruff, pyright.